学习频道
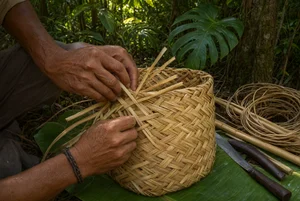
马来西亚本土文化:原住民的千年传承与现代守护
马来西亚这片热带土地上,除了马来人、华人和印度人三大族群外,还生活着众多本土原住民族群。他们被称为"Orang Asli"(马来半岛原住民)、"Orang Asal"(沙巴和砂拉越原住民),是这片土地最早的守护者,承载着独特而珍贵的文化遗产。
 雾里看花
多元语境下的语言蜕变:马来西亚留学生的语言学习之旅
近年来,马来西亚凭借高性价比的教育资源和多元文化氛围,成为热门留学目的地。然而,踏上这片热带土地,留学生们面临的挑战往往始于语言。马来西亚是一个多语种交融的国度,在这里,语言学习不仅是为了完成学业,更是一场深度的跨文化修行。
雾里看花
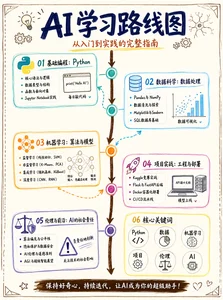
AI入门指南:在马来西亚留学,从零开始走进人工智能
在马来西亚留学,人工智能(AI)并不是一个只属于“编程高手”的遥远名词。它正在进入课堂、实验室、企业项目,也进入留学生每天的学习规划里。对于刚接触AI的人来说,入门并不意味着马上写出复杂算法,而是先建立一条清晰路径:了解AI是什么,掌握基础工具,选择学习方向,再通过项目把知识真正用起来。
 康康
当指标开始“反噬”:学术评价中的量化陷阱与自救指南
学术指标本身并非问题,但当概览与选拔共用同一套数字时,指标会从描述工具变为行为指挥棒,奖励“会刷数字的人”而非“做好研究的人”。文章用生活化案例拆解量化陷阱的结构性根源,并提出三项可立即上手的小练习:为指标补充“它没量到什么”、进行双指标对照、将概览与选拔分开记录。
 Leo_UTM
模型说错话时,怎么揪出“是谁教它的“?——数据归因里两个被低估的开关
文章讨论模型出错时的数据归因问题,指出两个常被低估的关键设置:一是将交叉熵梯度替换为负对数几率梯度,二是在聚合时仅取top-k token分数而非全文平均。仅这两处改动,ground truth召回率提升35至72个百分点。文章面向从事模型可解释性或训练数据溯源的研究者,旨在提供方法参考。
Leo_UTM
从零读懂 anthropics/financial-services:把“金融 AI 代理”跑起来的第一课
文章介绍 anthropics/financial-services 的三层工程结构,帮助初学者理解金融 AI 代理的基本组成,并通过最小链路实现读取财报、输出结论的流程。同时说明如何修改一个技能来验证对系统的理解深度,强调动手运行而非仅收藏。
Leo_UTM
从效率到效能,真正的AI组织
文章指出,许多机构在各部门KPI高分、数字化工具先进的情况下,仍面临净利率下滑、资本回报率低、战略项目拖延等困境。作者认为,问题不在于员工不努力,而在于组织已进入强耦合的商业模式,却仍用切碎分工的方式管理,导致资源错配和部门间相互抵消。文章提出,组织面临的主要矛盾已从局部效率转向全局效能,并探讨如何安放AI工具与守护底线的人,以走向智慧组织。
 邬予
详解Super Agent:会主动干活,更懂何时闭嘴
DeepSeek Harness团队于10月31日发布文章提出Super Agent概念,并在GitHub开源原型。Super Agent强调主动执行任务,能跨聊天软件、邮件和GitHub等场景持续工作,并通过Router与Worker分工机制实现任务分配与上下文隔离。系统借助规则与模型双重筛选判断何时主动介入、何时保持安静,并采用异步任务机制与云端大脑分离
 宋辞
四套代码训一个模型?也许一个损失函数就够了——“统一训练“给入门者的启发
文章指出,预训练、SFT和RL的本质差异仅在于数据来源不同,RL目标可推导为最大似然拟合,因此四阶段训练能够统一为一个算法加一张数据配比表。文中还提供最小可运行代码思路和面试高频考点,帮助读者理解post-training全链路,减少多套代码、权重搬运和灾难性遗忘带来的困扰。
Leo_UTM
AI 学习路线:从 1912 到 2026,按年代读什么、按能力练什么
文章针对AI学习资料多但难以形成体系的问题,提出一条按年代划分、可验证的学习路线。内容包含五个阶段总表,每阶段列出3至5篇必读材料、1项动手练习和可自行判断的过关标准,并附4个百行以内、可在CPU上运行的可交付项目。目标是在3个月内建立能够独立判断技术优劣的AI认知,覆盖从1912年到2026年的相关内容。
Leo_UTM